

Versions concernées : BI 4.2, 4.3, BI 2025 · Temps de lecture : 10 min
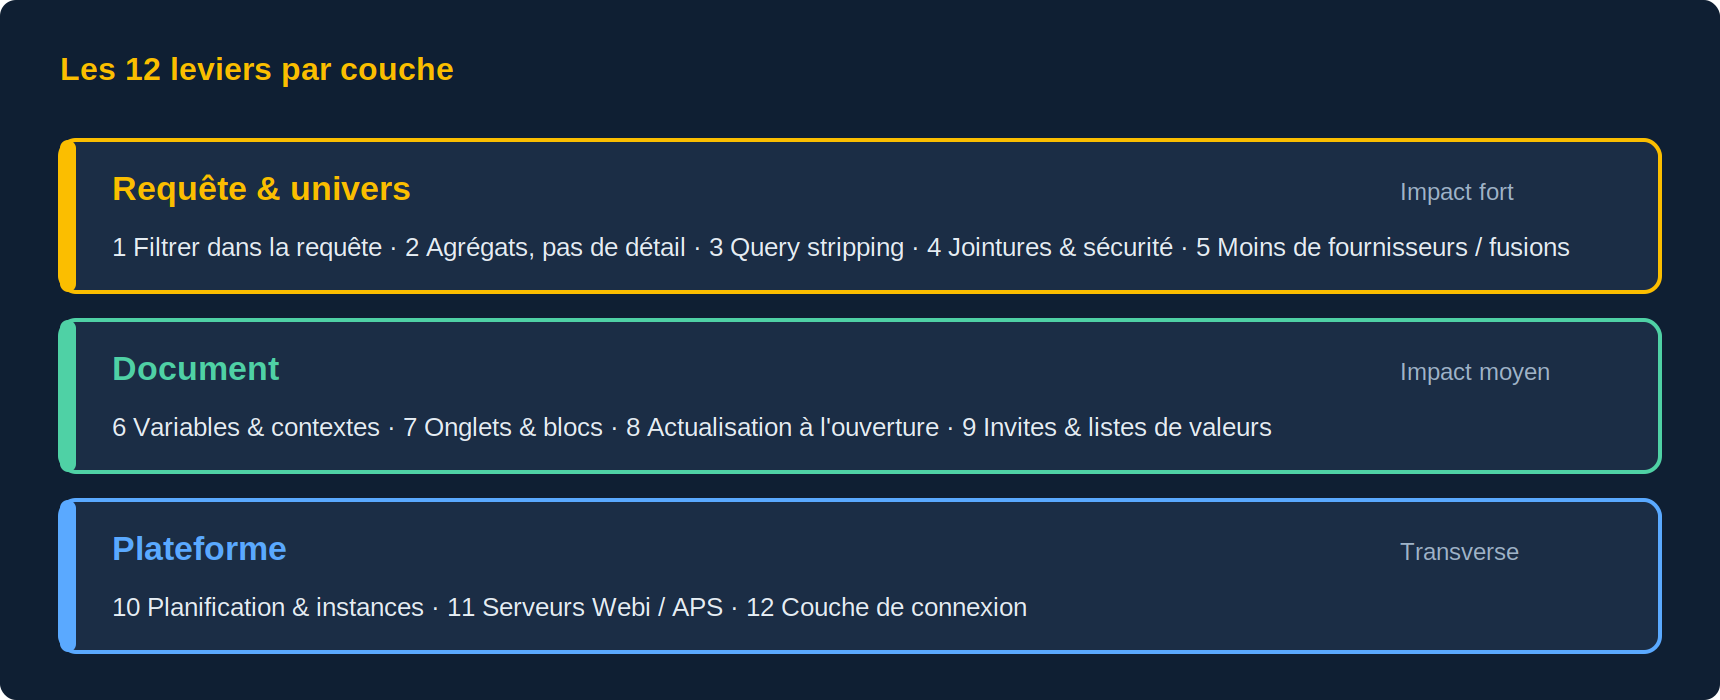
En résumé. Un rapport Web Intelligence lent a presque toujours une cause dominante, située dans l’une des quatre couches : la requête (SQL généré, volume ramené), l’univers (jointures, agrégats, sécurité), le document (formules, blocs, fusions) ou la plateforme (serveurs Webi, planification, cache). Optimiser sans avoir identifié la couche fait perdre du temps. Ce guide donne d’abord la méthode de diagnostic, puis 12 leviers classés par couche et par impact.
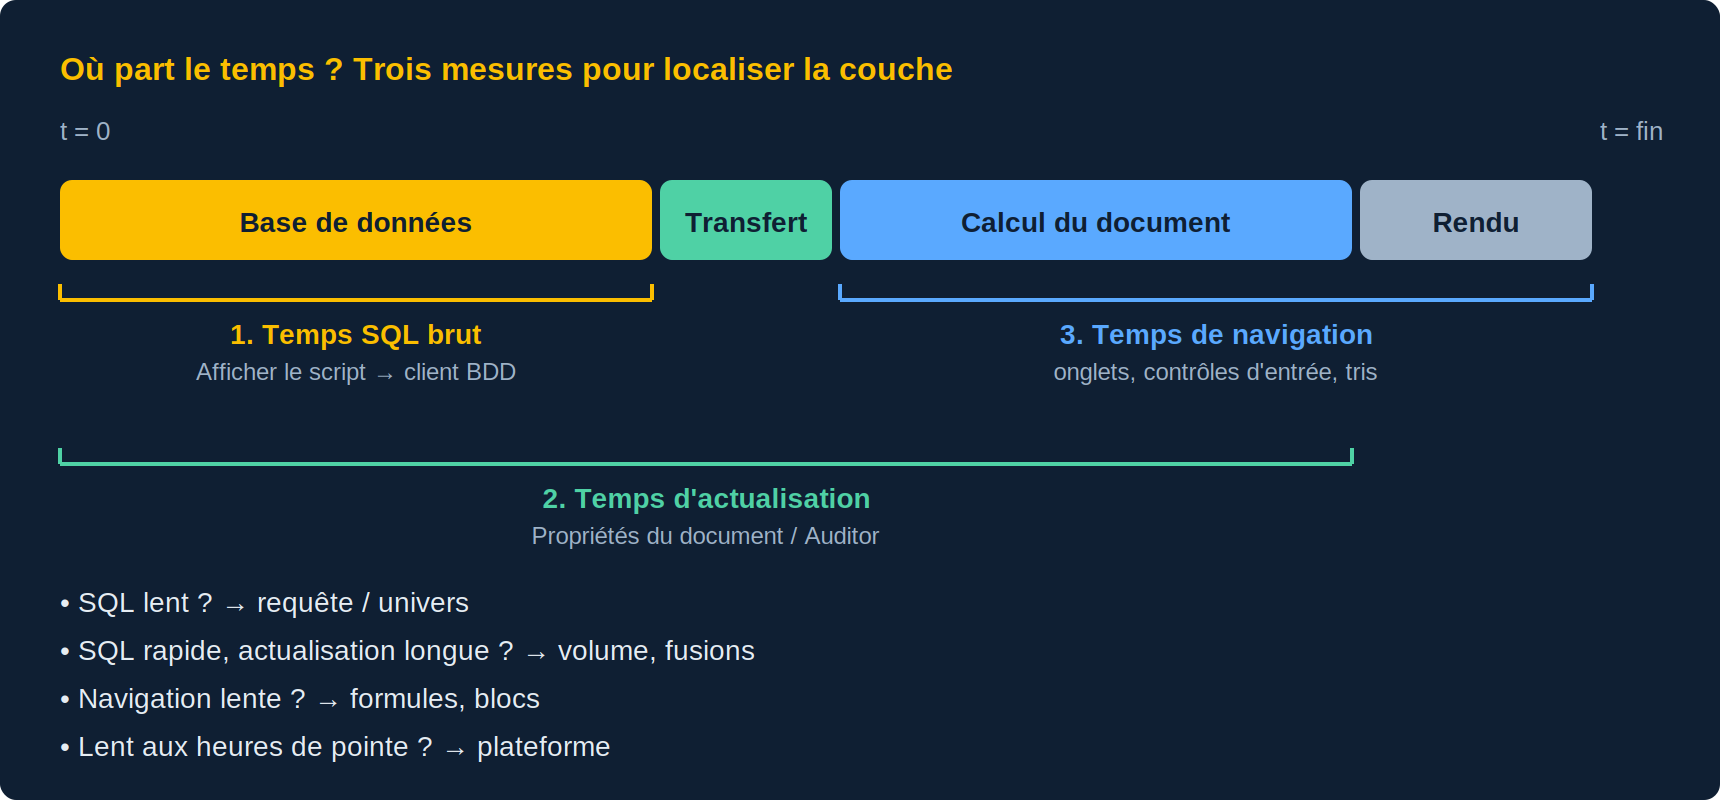
Étape 0 : où part le temps ?
Trois mesures suffisent pour localiser le problème dans 90 % des cas :
- Temps SQL brut : dans l’éditeur de requête, Afficher le script, puis exécuter ce SQL dans un client base de données (DBeaver, SQL Developer, SSMS). Notez le temps et le nombre de lignes.
- Temps d’actualisation : propriétés du document, dernière durée d’actualisation, ou l’Auditor si activé.
- Temps de navigation : changement d’onglet, application d’un contrôle d’entrée, tri. Si c’est là que ça rame, la requête n’est pas en cause.
| Symptôme | Couche probable | Leviers |
|---|---|---|
| SQL lent dans le client base | Requête / univers | 1 à 5 |
| SQL rapide, actualisation longue | Volume transféré, fusion, formules | 2, 5, 6, 8 |
| Actualisation correcte, navigation lente | Document | 6, 7, 9 |
| Rapide seul, lent aux heures de pointe | Plateforme | 10, 11, 12 |
| Lent uniquement pour certains utilisateurs | Sécurité / restrictions d’univers | 4, 12 |
Couche requête et univers
1. Filtrer dans la requête, pas dans le rapport
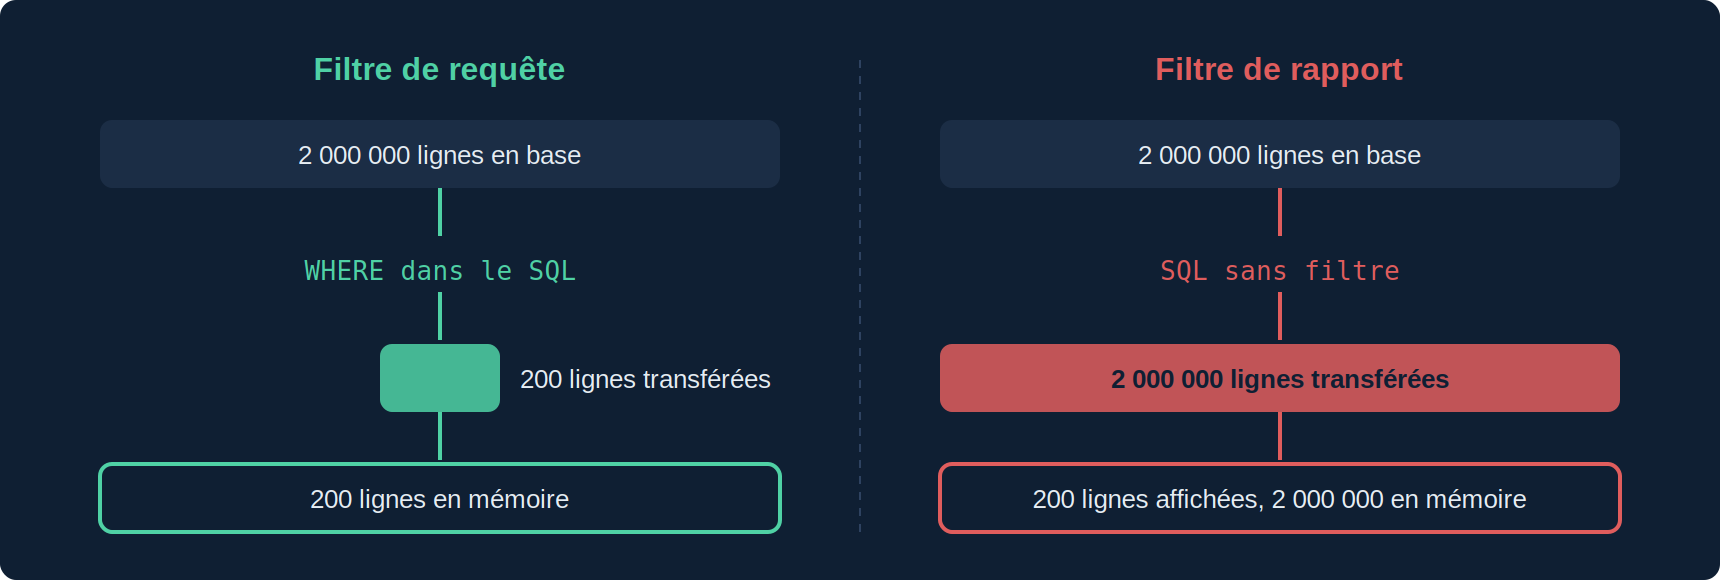
Un filtre de requête devient une clause WHERE : moins de lignes lues, transférées et stockées. Un filtre de rapport masque des lignes déjà chargées dans le cube du document. Règle simple : tout ce qui ne sera jamais affiché doit être filtré dans la requête, via des invites si le périmètre varie.
2. Ramener des agrégats, pas du détail
Le premier symptôme d’un rapport mal conçu est un nombre de lignes très supérieur au nombre de lignes affichées. Si le rapport montre 200 lignes par mois et par région, la requête ne doit pas ramener 2 millions de transactions. Utilisez les mesures agrégées de l’univers, et si le besoin est récurrent, une table d’agrégats avec aggregate awareness.
3. Activer le query stripping
Propriétés du document, option Activer le query stripping : les objets présents dans la requête mais utilisés nulle part dans les rapports sont retirés du SQL généré. Très efficace sur BW/BEx, utile aussi en relationnel depuis BI 4.x. Idéal sur les documents « fourre-tout » enrichis au fil des ans.
4. Auditer les jointures et la sécurité de l’univers
Regardez le SQL généré : jointures en boucle résolues par des contextes lourds, tables de dimension jointes sans objet sélectionné, restrictions d’accès (profils de sécurité) ajoutant des sous-requêtes. Les shortcut joins, l’index awareness (filtrer sur la clé plutôt que le libellé) et des contextes propres suppriment souvent la moitié du temps SQL sans toucher au rapport.
5. Limiter les fournisseurs de données et les fusions
Chaque requête est un aller-retour vers la base et un cube supplémentaire en mémoire ; chaque dimension fusionnée impose une synchronisation ligne à ligne. Trois requêtes fusionnées sur une dimension à forte cardinalité (client, produit) sont un classique des documents qui « prennent 20 secondes à chaque clic ». Quand c’est possible, une seule requête sur une vue ou une table de faits consolidée bat toujours la fusion.
Couche document
6. Simplifier variables et contextes de calcul
Les variables imbriquées sur plusieurs niveaux, les contextes ForEach sur des dimensions de forte cardinalité et les fonctions de chaînes (Match, Substr, Pos) appliquées ligne à ligne sont recalculés à chaque interaction. Tout ce qui peut être calculé dans l’univers ou la base doit l’être. Pour le reste, préférez des contextes In explicites, plus prévisibles et plus rapides à évaluer (voir notre guide des contextes de calcul).
7. Réduire les onglets et les blocs
Tous les rapports (onglets) d’un document sont calculés à l’actualisation, y compris ceux que personne n’ouvre, et les blocs masqués le sont aussi. Un document de 15 onglets et 80 blocs est un document de 15 rapports. Supprimez les onglets orphelins, fusionnez les blocs redondants, et évitez les tableaux de plusieurs dizaines de milliers de lignes : Webi n’est pas un outil d’export.
8. Désactiver l’actualisation à l’ouverture quand elle est inutile
Si les données changent une fois par jour, un document qui s’actualise à chaque ouverture interroge la base pour rien. Servez plutôt la dernière instance planifiée (levier 10). L’actualisation à l’ouverture se justifie pour les rapports en temps réel ou avec invites obligatoires.
9. Alléger invites et listes de valeurs
Une invite sur un objet dont la liste de valeurs fait 500 000 entrées est lente avant même que la requête ne parte. Utilisez des listes de valeurs en cascade, des listes personnalisées (statiques ou basées sur une table de référence) et, dans l’univers, désactivez l’actualisation automatique de la LOV quand ce n’est pas nécessaire.
Couche plateforme
10. Planifier les rapports lourds et servir les instances
Le levier le plus rentable pour les rapports de direction : planifiez-les la nuit et distribuez les instances. L’utilisateur ouvre un document déjà calculé, le serveur n’est pas sollicité aux heures de pointe, et la base non plus. Les publications permettent en plus une diffusion personnalisée par destinataire.
11. Dimensionner et régler les serveurs Webi
Sur le Web Intelligence Processing Server : nombre maximal de connexions, taille du cache document, mémoire maximale par processus. Sur l’APS : services séparés (DSL Bridge pour BW, Visualization) plutôt qu’un APS monolithique. Le guide de sizing SAP donne les ordres de grandeur ; un serveur surdimensionné ne compense jamais un document mal conçu, mais un serveur sous-dimensionné pénalise même les bons.
12. Vérifier la couche de connexion
Pilote (JDBC souvent plus rapide qu’ODBC sur les gros volumes), array fetch size (la valeur par défaut est souvent trop basse pour des résultats volumineux), pool de connexions, et latence réseau entre les serveurs Webi et la base. Ce sont des réglages invisibles pour les concepteurs de rapports, mais ils s’appliquent à tous les documents d’un coup.
Checklist rapide avant de mettre un rapport en production
- Le nombre de lignes ramenées est du même ordre que le nombre de lignes affichées.
- Aucun filtre de rapport ne pourrait être un filtre de requête.
- Query stripping activé, actualisation à l’ouverture justifiée.
- Une seule requête, ou des fusions sur des dimensions de faible cardinalité.
- Pas plus de deux niveaux de variables imbriquées.
- Aucun onglet ni bloc inutilisé.
- Les rapports lourds et récurrents sont planifiés.
Questions fréquentes
Comment savoir si la lenteur vient de la base ou de Webi ?
Exécutez le SQL généré dans un client base de données. S’il est aussi lent que l’actualisation, le problème est côté requête/base. S’il est rapide, il est dans le document ou sur le serveur Webi.
Un filtre de requête est-il vraiment plus rapide qu’un filtre de rapport ?
Oui, presque toujours : il réduit les lignes lues et transférées, alors que le filtre de rapport ne fait que masquer des lignes déjà chargées.
Qu’est-ce que le query stripping ?
Une option du document qui retire du SQL les objets non utilisés dans les rapports. Très efficace sur BW/BEx, disponible aussi en relationnel.
Faut-il augmenter la mémoire du serveur Webi ?
Seulement après avoir traité la requête et le document. Sinon vous masquez le problème et le retrouvez au rapport suivant.
Les tableaux de bord Webi sont-ils forcément lents ?
Non, mais un tableau de bord Webi consomme une session serveur par utilisateur et par ouverture. Pour une large diffusion, il est souvent plus efficace de publier une version HTML autonome, calculée une fois et servie sans charge sur la plateforme.
Sources et références
- SAP Help Portal — Guide de l’utilisateur SAP BusinessObjects Web Intelligence (BI 4.3 / 2025)
- SAP Community — Hub SAP BusinessObjects BI Platform
- Retours terrain Need4Viz sur des déploiements BI 4.1 à BI 2025
- SAP Help Portal — Guide de l’utilisateur de l’Information Design Tool
- SAP Help Portal — Guide d’administration de la plateforme SAP BusinessObjects BI
👉 Découvrez Need4Viz et ce que nous apportons vraiment à SAP Web Intelligence
Need4Viz étend SAP Web Intelligence avec des capacités avancées de dataviz, d'interactivité, d'automatisation et d'IA pour transformer vos rapports en véritables outils de pilotage.
Découvrir Need4Viz