

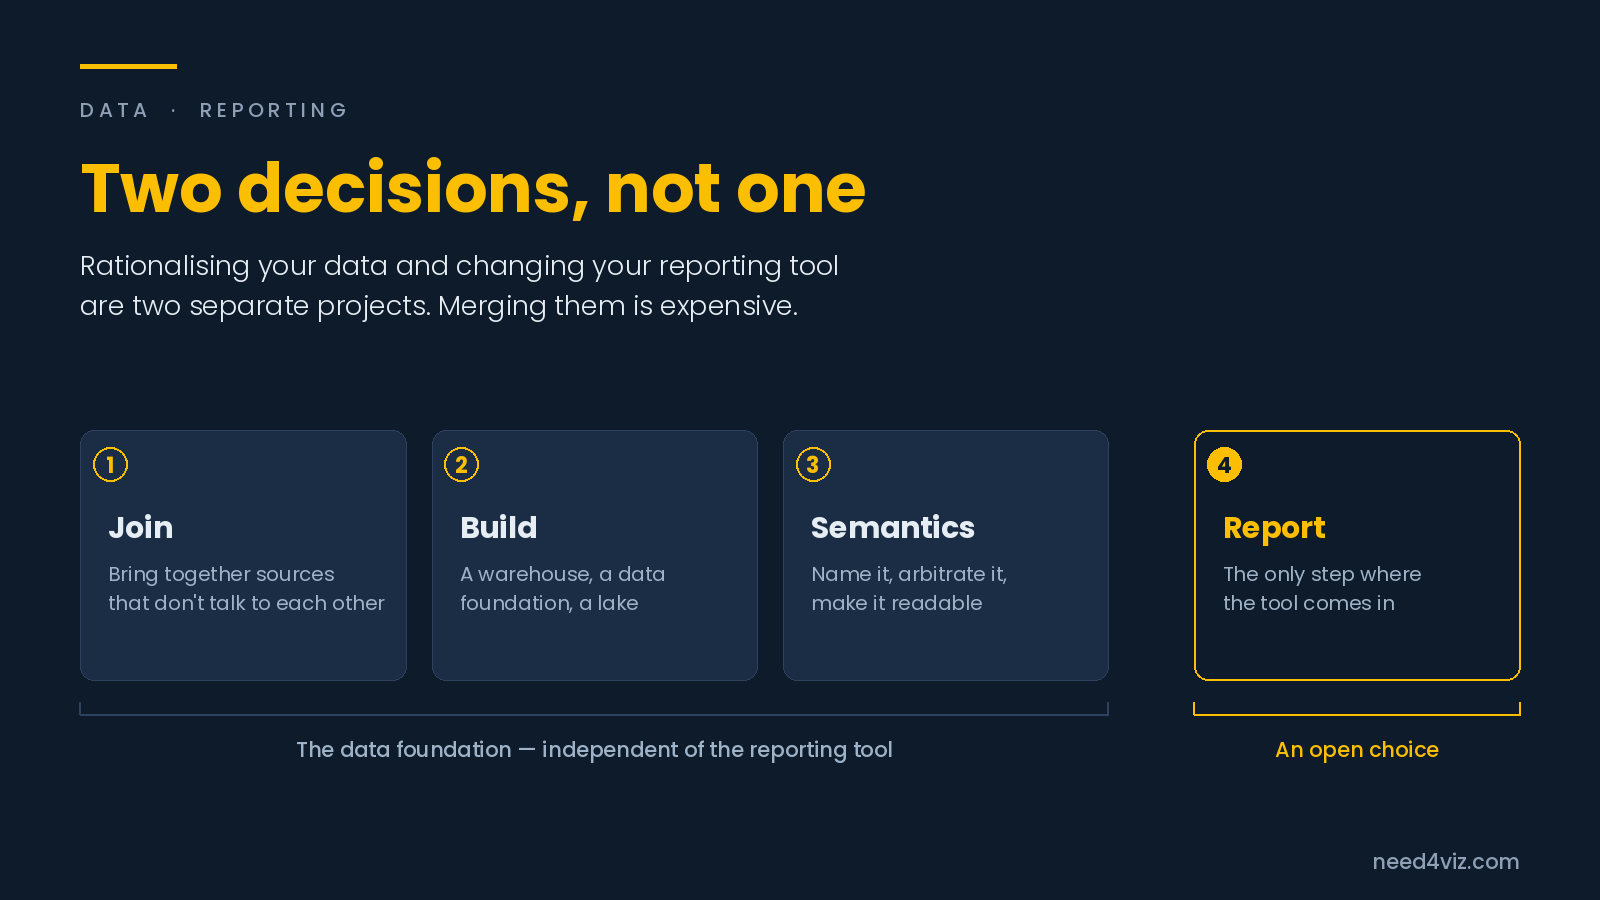
Les projets data butent rarement sur la technique. Ils butent sur une décision prise trop tôt, et pour de mauvaises raisons : celle de l’outil qui affichera les résultats.
Le scénario se répète d’une organisation à l’autre. Une direction générale constate qu’elle n’obtient pas de réponse à des questions pourtant simples. Une étude est lancée. Elle conclut, à juste titre, qu’il faut un socle de données commun. Et quelque part dans la même conclusion, une ligne engage aussi le remplacement de l’outil décisionnel historique.
Ces deux décisions n’ont pourtant rien à voir l’une avec l’autre. La première crée de la valeur. La seconde consomme le budget, le calendrier et la patience des utilisateurs. Et c’est presque toujours la seconde qui est tranchée en premier.
Les questions qui ne trouvent pas de réponse
Avant de parler d’architecture, il faut regarder ce qui déclenche ces projets. Ce sont toujours des questions concrètes, posées en comité de direction, auxquelles personne ne sait répondre en moins de trois semaines.
Combien coûte réellement un dispositif d’aide ? La réponse suppose de rapprocher les bénéficiaires suivis par l’action sociale, les mandats émis par la direction financière et les subventions versées aux structures partenaires. Trois applications, trois responsables, trois définitions du mot « bénéficiaire ».
Quelle est la charge réelle de nos services instructeurs ? Il faut croiser les effectifs présents, mois par mois, avec les volumes de dossiers traités par nature. Les deux chiffres existent. Ils n’ont jamais été rapprochés parce qu’ils vivent dans des systèmes qui ne partagent aucune clé commune.
Notre programmation d’investissement tient-elle la route ? Il faut relier l’état du patrimoine aux engagements déjà pris et aux capacités de financement. Trois directions, trois horizons de temps, trois fichiers Excel qui ne se recoupent qu’une fois par an.
Que se passe-t-il sur ce territoire ? La plus banale, et la plus révélatrice. Elle suppose un référentiel géographique commun — communes, cantons, quartiers — que chaque application code à sa manière, quand elle le code.
Dans les quatre cas, la donnée existe déjà. Elle est simplement dans deux systèmes qui ne se parlent pas. C’est un problème de données, pas un problème de graphiques.
Le parcours en quatre étapes
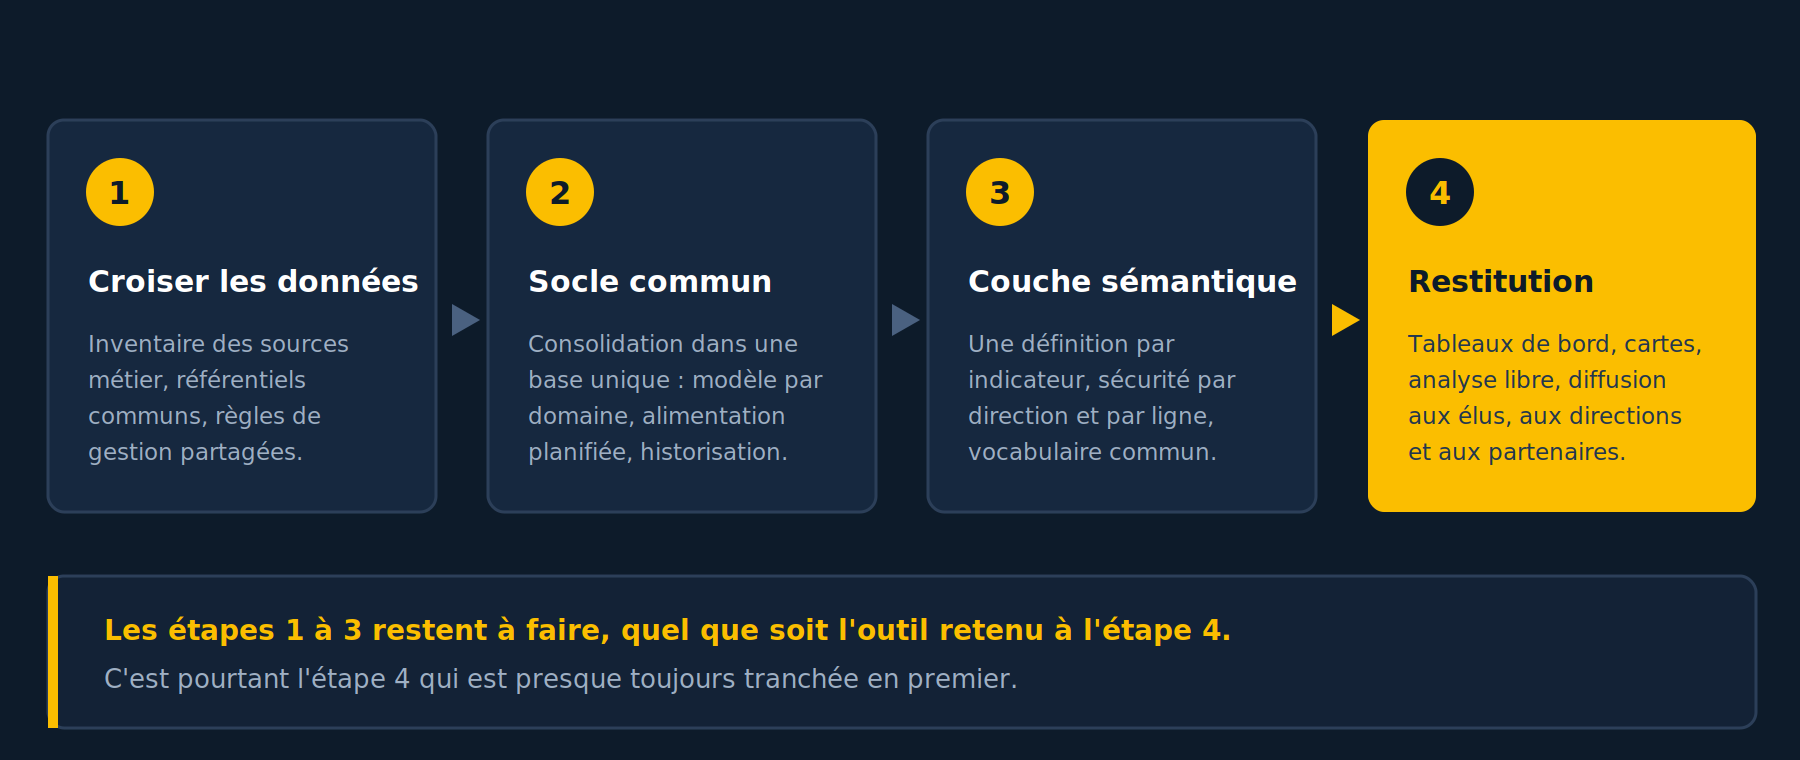
Tout projet de ce type suit le même enchaînement, quel que soit le vocabulaire employé par le cabinet qui l’accompagne.
Croiser les données consiste à inventorier les sources métier, établir les référentiels communs — tiers, communes, structures, nomenclatures — et à se mettre d’accord sur les règles de gestion. C’est long, c’est politique, et c’est là que se joue le succès du projet.
Construire le socle consiste à consolider ces sources dans une base unique, organisée par domaine, alimentée régulièrement, avec historisation et contrôles de qualité.
Définir la couche sémantique consiste à donner une définition unique à chaque indicateur, à porter la sécurité par direction et par ligne, et à traduire les tables en vocabulaire métier. C’est ce qui permet à un agent de manipuler des données sans écrire une requête.
Restituer consiste enfin à produire les tableaux de bord, les cartes, l’analyse libre, et à les diffuser aux élus, aux directions et aux partenaires.
Trois de ces quatre étapes ne dépendent pas de l’outil de restitution. Elles seront à faire à l’identique, que la quatrième étape soit assurée par la plateforme en place ou par un produit acheté l’an prochain. C’est le point que les études escamotent le plus souvent.
Trois façons de croiser les données
L’autre raccourci fréquent consiste à présenter le socle de données comme un projet unique, monolithique, à budgéter en une fois. Il existe en réalité trois approches, de coût et de délai très différents, et elles se cumulent.
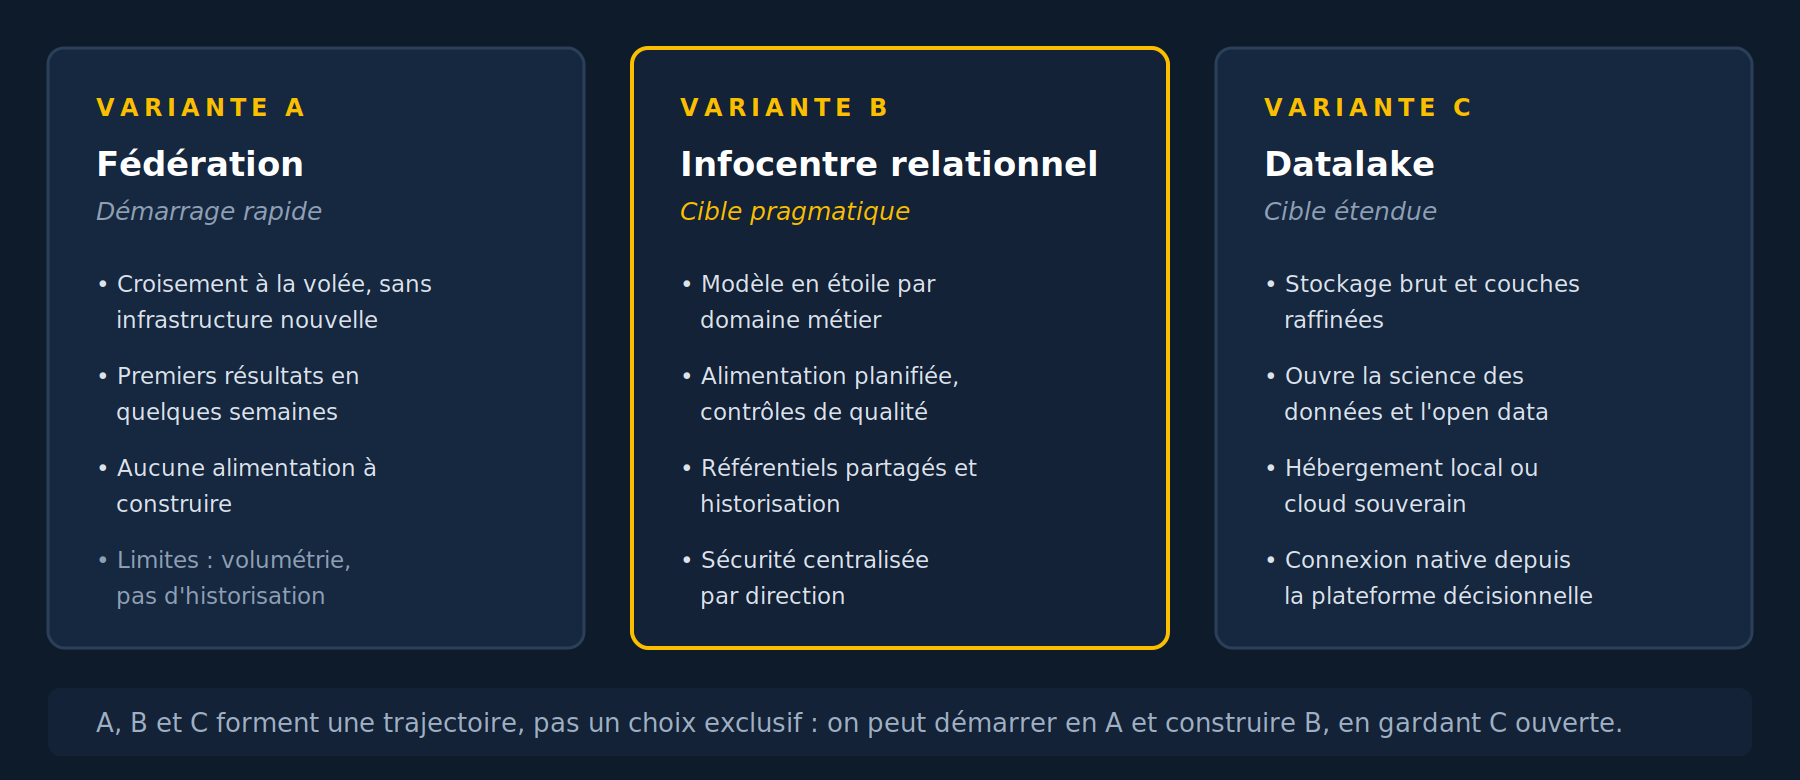
La fédération consiste à croiser les sources à la volée, au moment de la requête, sans rien stocker de nouveau. Aucune infrastructure à monter, aucune alimentation à construire : les premiers croisements sortent en quelques semaines. Les limites sont réelles — la volumétrie plafonne vite et rien n’est historisé — mais c’est une excellente façon de vérifier que les référentiels tiennent avant d’investir.
L’infocentre relationnel est la cible pragmatique. Une base classique, un modèle en étoile par domaine métier, une alimentation nocturne, des référentiels partagés et de l’historisation. Rien d’exotique, des compétences disponibles, un coût maîtrisable. Dans la plupart des organisations, c’est la bonne réponse — et il est fréquent qu’une brique existe déjà, livrée avec un progiciel métier, qui peut servir de point de départ.
Le datalake ouvre plus large : stockage brut, couches raffinées, hébergement local ou cloud souverain, et la possibilité de faire de la science des données et de l’open data en plus du reporting. C’est une cible légitime, rarement un point de départ raisonnable.
Ces trois approches forment une trajectoire. Démarrer par la fédération pour produire des résultats visibles, construire l’infocentre comme cible, garder le datalake ouvert : c’est plus sûr, et plus vendable en interne, qu’un grand projet de trois ans dont rien ne sort avant la deuxième année.
Le glissement
Reste à comprendre pourquoi une étude qui portait sur la donnée finit par recommander un changement d’outil. Trois mécanismes reviennent.
L’outil historique paraît daté. Il l’est souvent, visuellement. Mais ce qui est daté, c’est la mise en forme des restitutions, pas la capacité de la plateforme à interroger des données. On confond l’apparence des rapports avec l’architecture qui les produit — et on remplace la seconde pour régler la première.
Un fournisseur propose le socle et la visualisation dans le même lot. C’est commercialement habile et opérationnellement séduisant : un interlocuteur, un contrat, un calendrier. Le coût est ailleurs, dans la dépendance créée et dans tout ce qui devra être reconstruit.
Le coût de l’existant est chiffré, celui du remplacement ne l’est pas encore. D’un côté une ligne de maintenance connue, de l’autre une estimation de projet qui ne comptabilise ni la reconstruction des rapports, ni la formation, ni les mois pendant lesquels deux plateformes cohabitent. La comparaison est faussée dès le départ.
Ce que le remplacement emporte avec lui
Changer d’outil de restitution ne se limite jamais à installer un nouveau produit. Il faut aussi :
- reconstruire le parc de rapports existants, dont personne ne connaît le nombre exact avant de l’avoir compté ;
- réécrire les règles de sécurité, direction par direction et ligne par ligne ;
- reformer les agents qui produisent leurs propres analyses, et accepter qu’une partie d’entre eux ne franchisse pas le pas ;
- maintenir deux plateformes pendant toute la transition, avec le risque bien connu des deux versions du même chiffre en réunion.
Il existe un cinquième point, moins souvent anticipé. Les éditeurs de progiciels métier — finances, ressources humaines, action sociale, patrimoine — livrent leurs restitutions pour les plateformes décisionnelles établies. Changer d’outil, c’est renoncer à ce qui est livré avec les applications, et le refaire à ses frais à chaque évolution réglementaire.
La quatrième étape est un choix ouvert
L’argument qui justifie le remplacement est presque toujours le même : la plateforme historique ne saurait pas se connecter au nouveau socle. C’est faux, et c’est facile à vérifier.
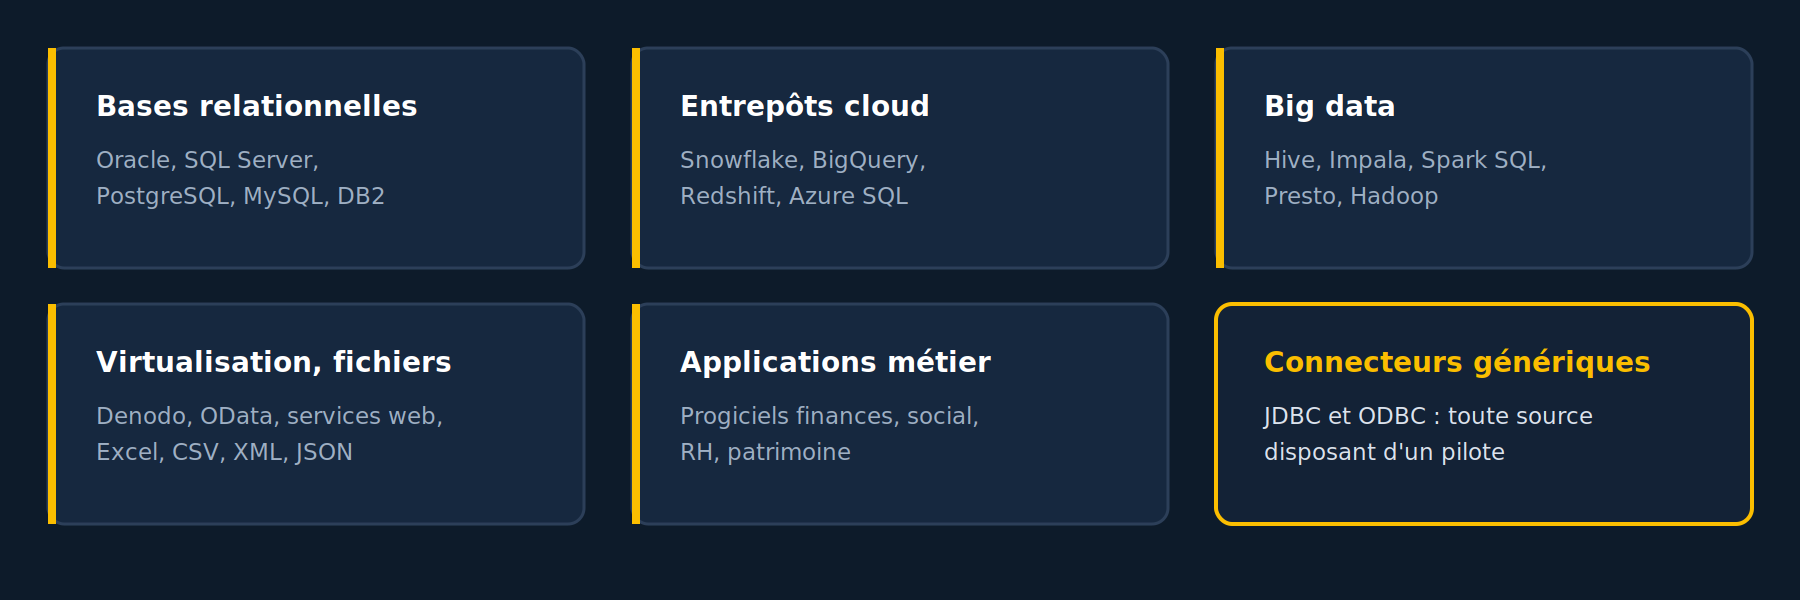
Une plateforme décisionnelle d’entreprise se connecte aujourd’hui aux bases relationnelles classiques, aux entrepôts cloud, aux moteurs big data, aux couches de virtualisation, aux fichiers et aux services web — sans compter les connecteurs génériques, qui couvrent toute source disposant d’un pilote. La matrice de compatibilité de l’éditeur en recense plus d’une centaine, et il est prudent de la consulter pour sa propre version plutôt que de se fier à une idée reçue.
S’y ajoutent des capacités souvent oubliées dans les comparatifs : croiser plusieurs sources dans un même document, centraliser les droits et l’authentification, planifier et diffuser en masse, tracer les usages.
Le sujet n’est donc pas la connectivité. Le sujet, c’est la mise en forme — et la mise en forme se modernise sans changer de plateforme. C’est exactement ce que fait N4V FOR WEBI : des tableaux de bord au niveau des outils les plus modernes, de la cartographie, de l’analyse en langage naturel et une diffusion HTML5 sans licence supplémentaire, installés sur la plateforme déjà en place. Les rapports restent, les compétences restent, la sécurité reste. Le projet se compte en semaines.
Cinq questions avant d’arbitrer
- Notre décision sur le socle de données dépend-elle vraiment de l’outil de restitution ?
- Combien de rapports actifs avons-nous exactement, et qui les reconstruira ?
- Que deviennent les restitutions livrées par nos éditeurs métier si nous changeons d’outil ?
- Avons-nous comparé le coût complet des scénarios, transition comprise, ou seulement les prix d’acquisition ?
- Un outil déjà écarté par les utilisateurs pour sa complexité l’a-t-il été pour de bonnes raisons ? Si oui, qu’est-ce qui garantit que le suivant sera adopté ?
Séparer les deux décisions
Rien n’oblige à trancher la restitution en même temps que le socle. Décider du socle sur sa capacité à croiser les données, et de la restitution sur la continuité qu’elle préserve, c’est deux arbitrages plus simples que le grand arbitrage unique — et deux fois moins de risques de se tromper.
Dans la plupart des dossiers que nous voyons, le socle mérite l’investissement et la restitution mérite d’être modernisée, pas remplacée.
Une étude de rationalisation en cours ?
Nous intervenons volontiers comme troisième scénario dans les comparatifs : ce que devient votre parc de rapports, ce que coûte réellement chaque option, et ce qui se modernise sans rien reconstruire.
À lire aussi
👉 Découvrez Need4Viz et ce que nous apportons vraiment à SAP Web Intelligence
Need4Viz étend SAP Web Intelligence avec des capacités avancées de dataviz, d'interactivité, d'automatisation et d'IA pour transformer vos rapports en véritables outils de pilotage.
Découvrir Need4Viz